分類 AI 下的文章

下面將每筆資料透過 _to_chat_text(...) 組成 ChatML 風格輸入

def _to_chat_text(tokenizer, instruction, user_input, output=None):
    """組成 ChatML 訓練 / 推理文本。output 為 None 時只到 assistant 起始。"""
    messages = [{"role": "user", "content": f"{instruction}\n\n文本:{user_input}"}]
    if output is not None:
        messages.append({"role": "assistant", "content": output})
        return tokenizer.apply_chat_template(messages, tokenize=False)
    return tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
- 閱讀剩餘部分 -

我們將使用 Qwen2.5-1.5B 加上 QLoRA 進行情緒語句的訓練與測試,原本的參數量來説 0.8B 模型就必須 12.8GB vram(全量微調),需要在消費級顯卡上進行測試,那麽就必須將參數量降下來,所以我們將在這裏使用 QLoRA 進行訓練推理,QLoRa 可以將 4bytes 降到 0.5bytes,并且凍結梯度、優化器狀態。

全量微調

组成 内容 FP32 參數
模型權重 x 4
梯度 x 4
優化器 Adam 的 m + v = 2x 8
合计 4x 16 bytes/參數

所以 0.8B × 16 = 12.8 GB,結果就是消费级顯卡(4080/16GB)連 1.5B 全量微調都做不到。

- 閱讀剩餘部分 -

今天來看下這篇文章,第一次看的時候沒意識到重要性,後來看某個面試官在闡述 agent 工程師的區別時特地説到這篇文章才想起來

Anthropic building-effective-agents


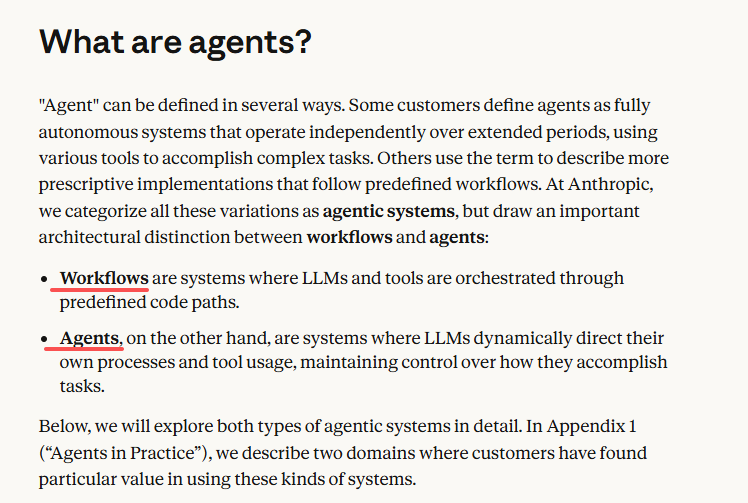
Anthropic 觀察了幾十個在生產環境落地的 LLM 系統,發現一個反直覺的規律:最成功的實作往往不是用最複雜的框架,而是用最簡單、可組合的模式。

他們把所有涉及 LLM 自主行動的系統統稱為 agentic system,但在這個概念下做了一個關鍵的架構區分——

03820-hnvwfyrbxcr.png

- 閱讀剩餘部分 -