Jev 實測:Choice、Score、Noul 三種題型,與 RLCD 為何比 RLHF 更誠實
近期 typesafe 的 Jev 模型非常火熱,專門為了結構化決策與機率校準(Probability Calibration)所設計的全新強化學習訓練方法。它完全打破了傳統大模型「生成文字」的範式,專注於提供極速、高精確度的「強型別(Typed)」決策。
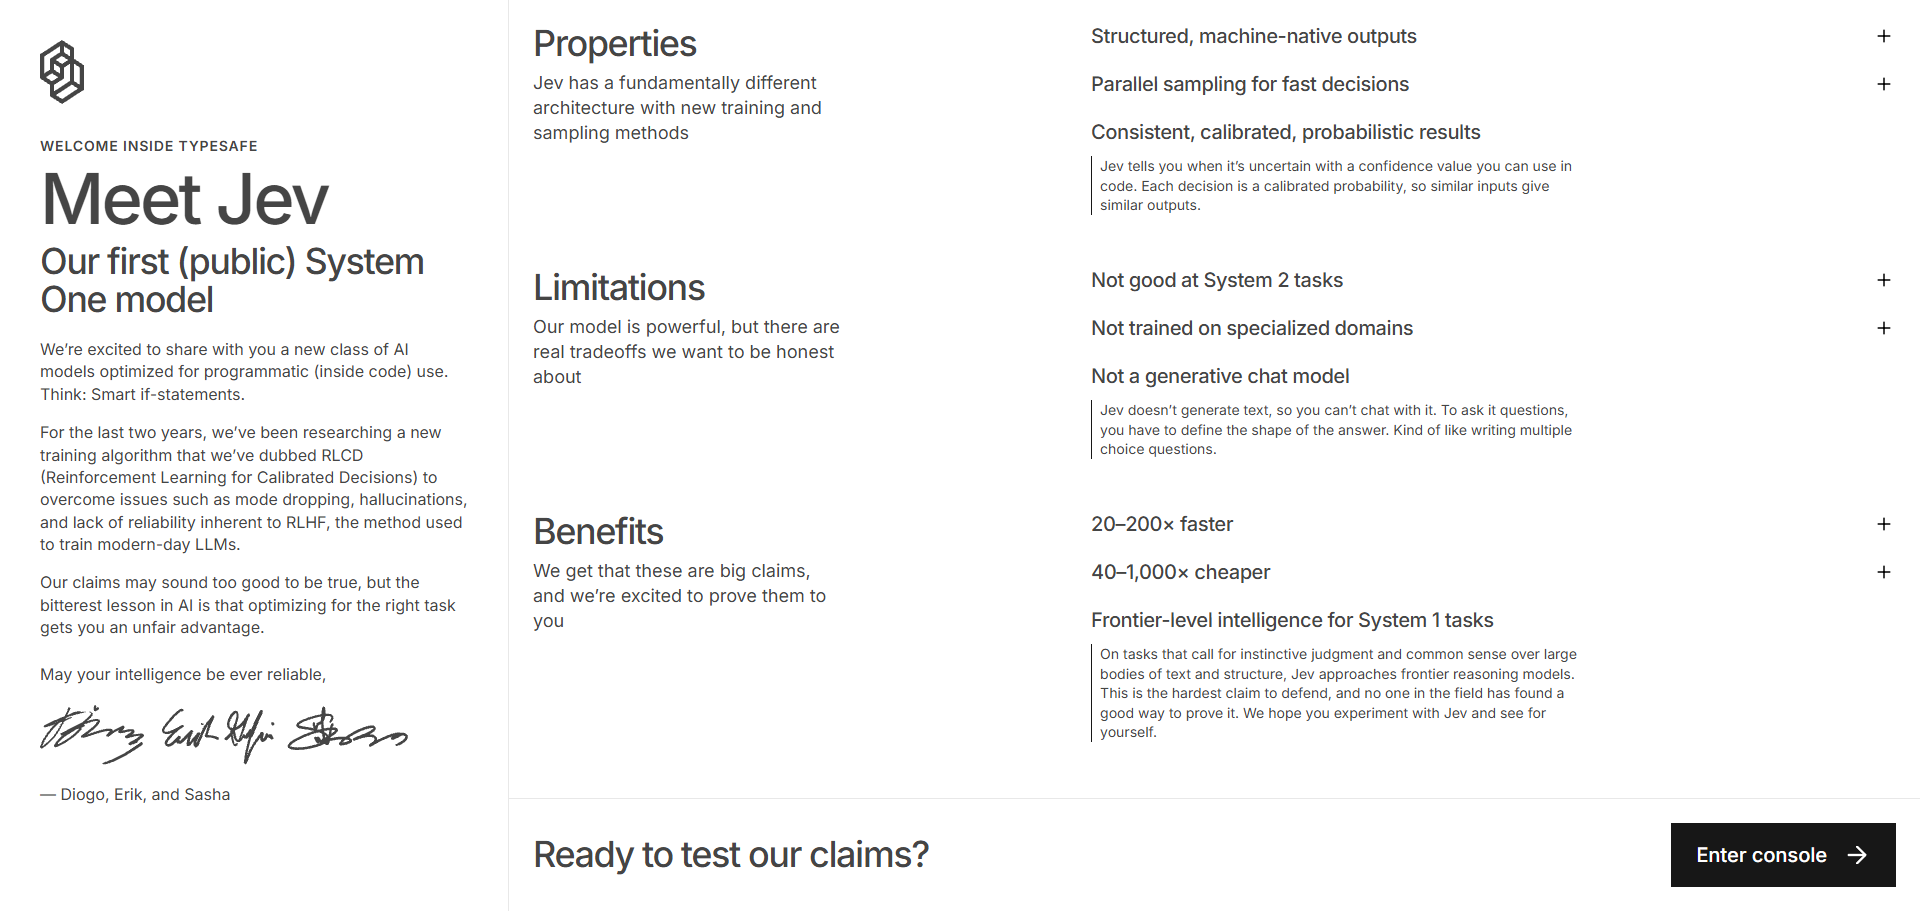
從Jev的官網可以看到幾個特點:
1. 定位與核心概念 (Core Concept)
- System 1 模型:Jev 是首個公開的 System 1 AI 模型(如同人腦直覺、快速回應的系統),專為程式內部使用(programmatic inside code)所優化。
- 「智慧型條件判斷」(Smart If-statements):主要用途是作為程式碼中的智慧控制點。
- 全新訓練算法 (RLCD):採用 RLCD(Reinforcement Learning for Calibrated Decisions,校準決策強化學習)來克服傳統 RLHF 的模式崩潰(mode dropping)、幻覺(hallucinations)及缺乏可靠性問題。
2. 主要特性 (Properties)
- 結構化且適合機器讀取的輸出 (Structured, machine-native outputs):輸出格式適合程式直接處理。
- 平行取樣 (Parallel sampling):能進行平行採樣以實現極速決策。
- 一致且經過校準的機率結果 (Consistent, calibrated, probabilistic results):不確定時會給出可在程式碼中利用的信心數值(confidence value),相似的輸入會產生相似的輸出。
3. 優勢與效益 (Benefits)
-
極高效率與極低成本:
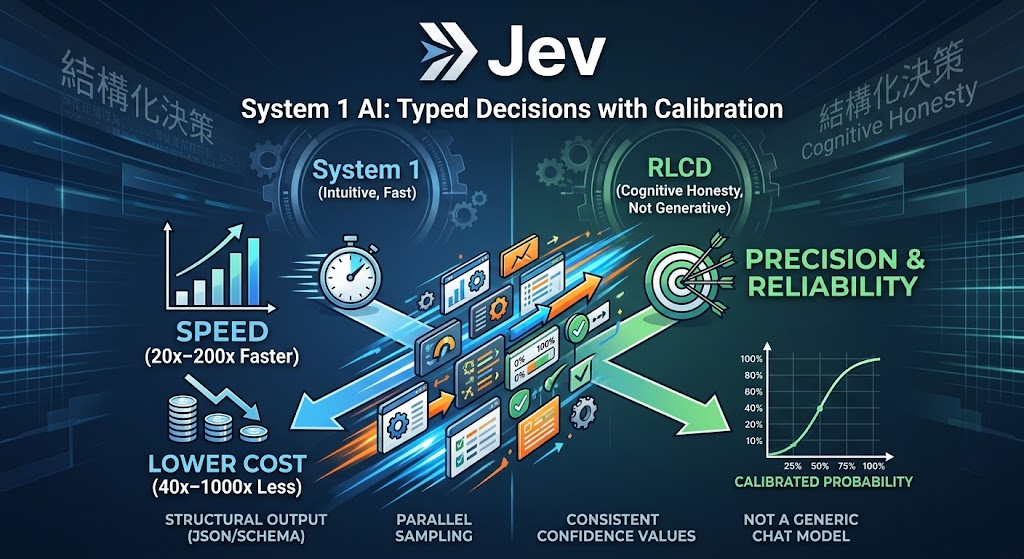
- 速度:比傳統模型快 20 到 200 倍。
- 成本:便宜 40 到 1,000 倍。
-
前沿級的 System 1 智力:在需要直覺判斷和常識處理的 System 1 任務上,表現可媲美最頂尖的推理模型。
4. 局限性 (Limitations)
- 不擅長 System 2 任務:不適合需要深思熟慮、複雜邏輯推演的任務。
- 未針對專業領域訓練:非特定專業領域的專門模型。
- 非生成式對話模型 (Not a generative chat model):無法像一般 LLM 進行生成式文字對話。若要向它提問,必須先定義好答案的結構形態(類似設計選擇題)。
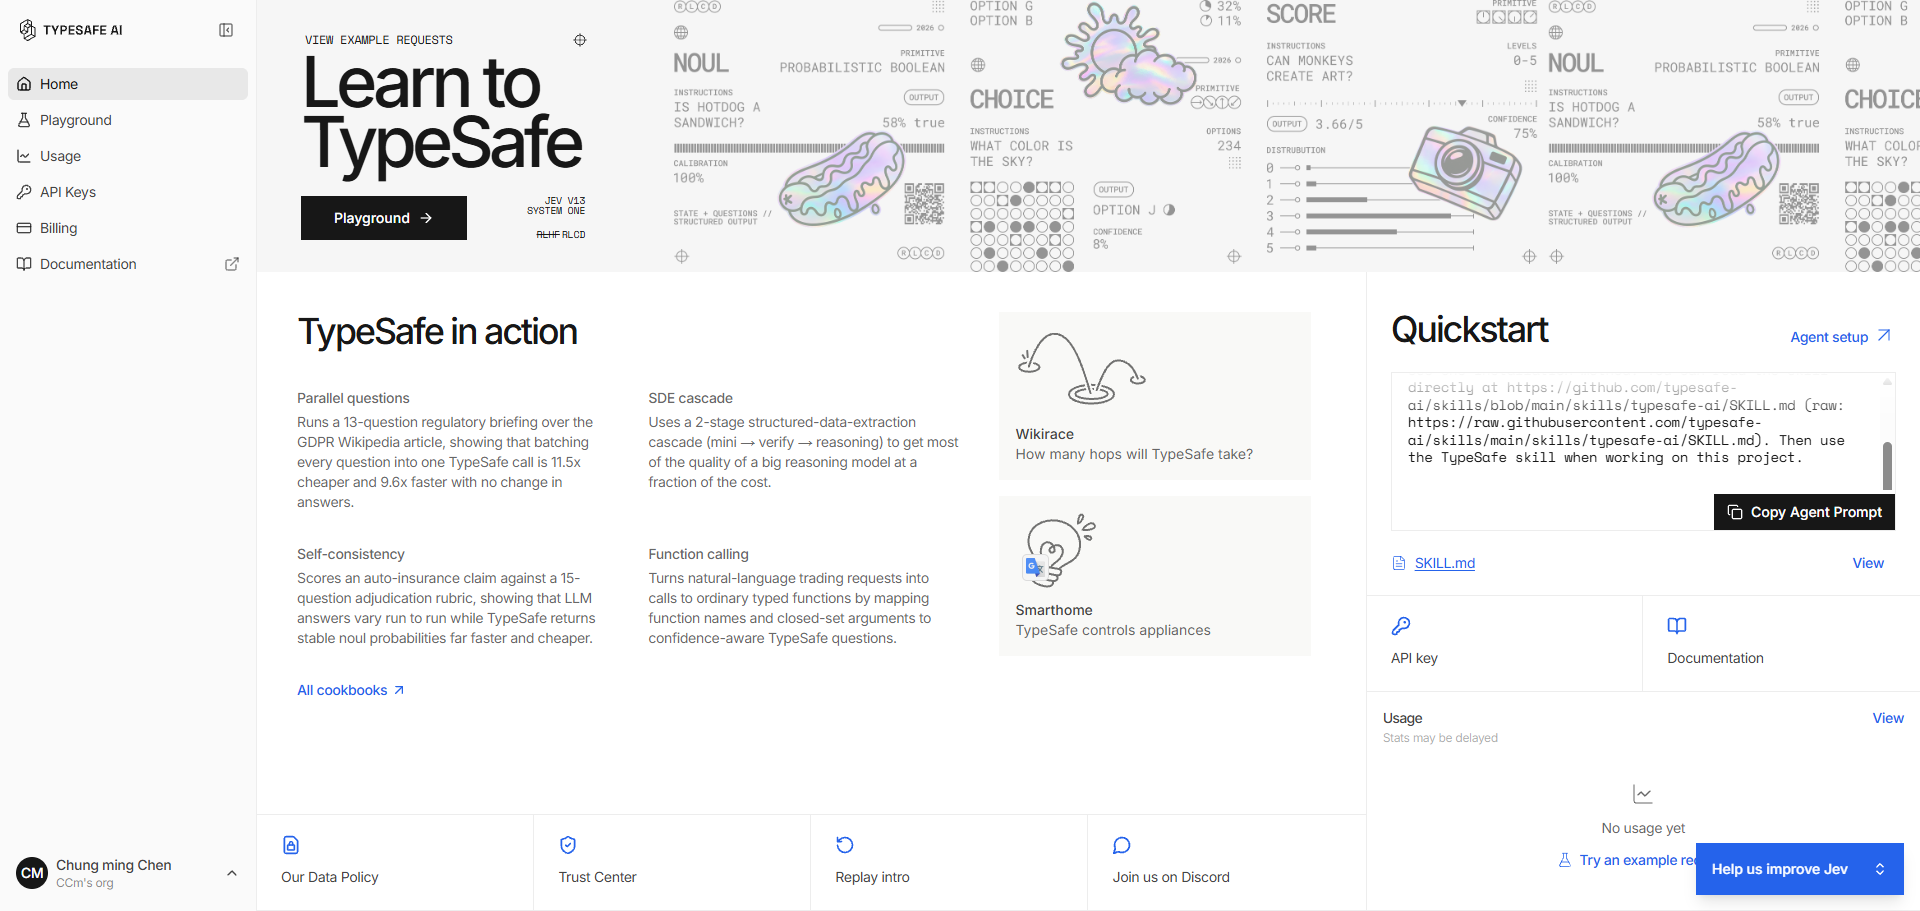
申請好之後進入 console 頁面
測試案例如下
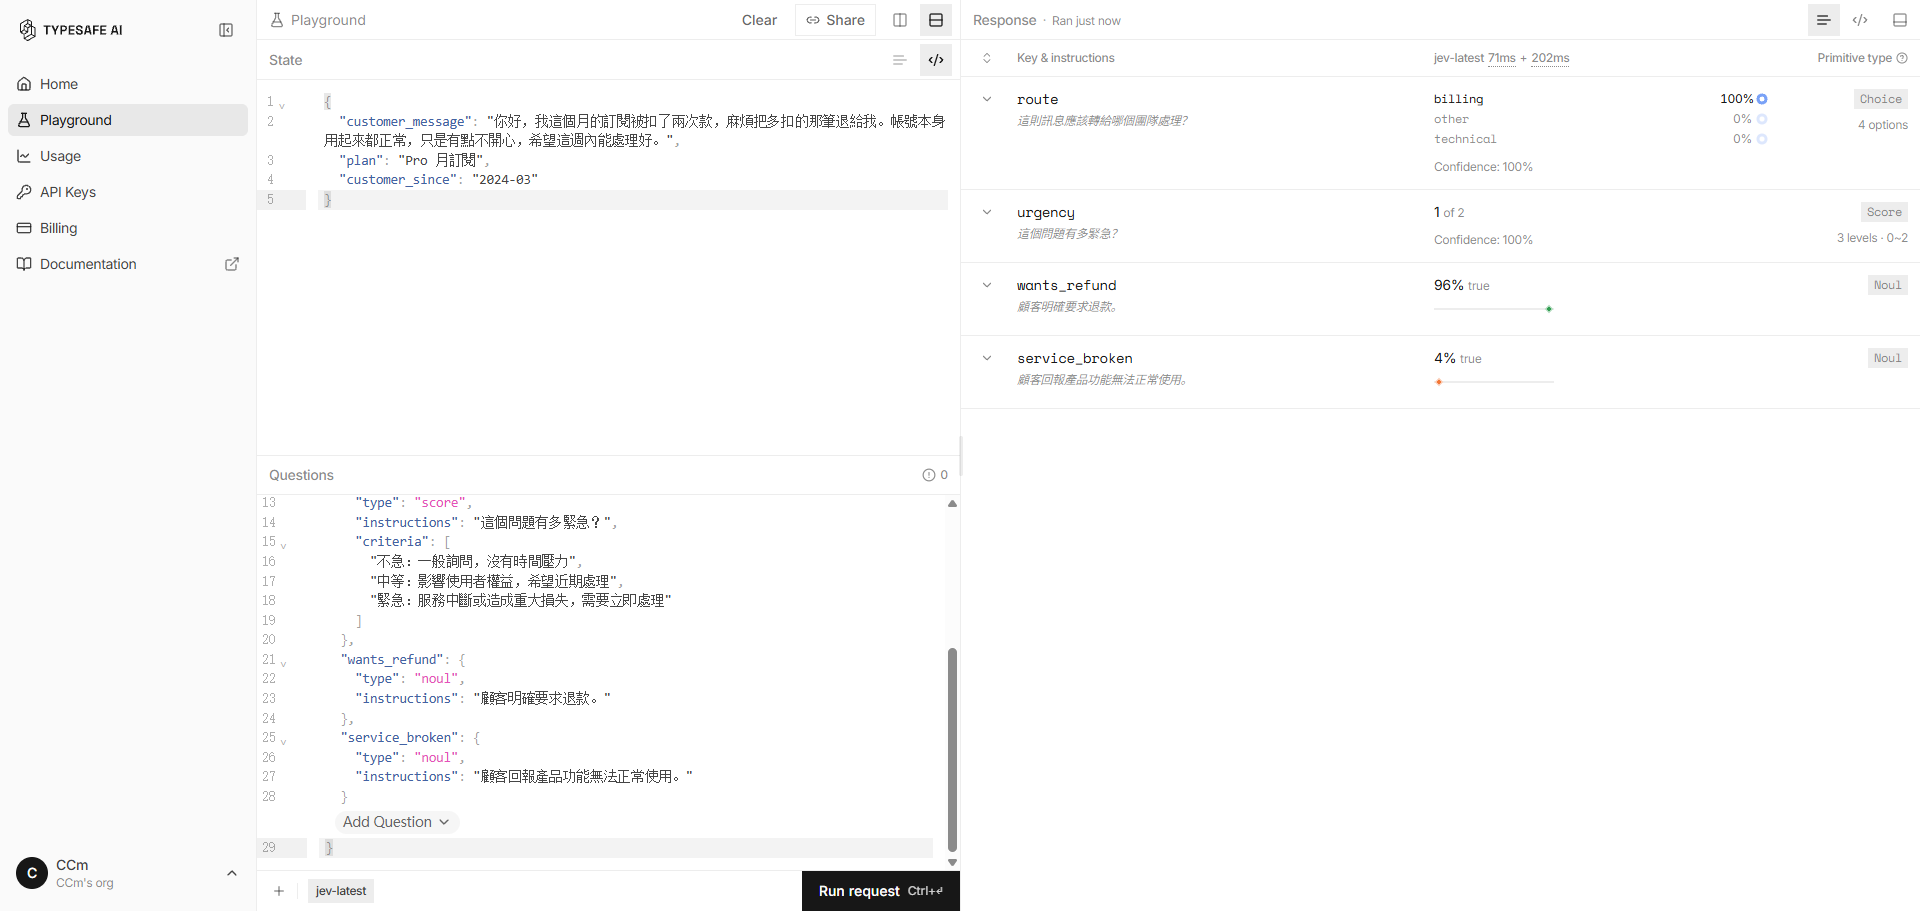
問題1:
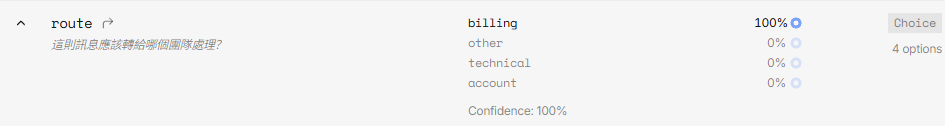
"route": {
    "type": "choice",
    "instructions": "這則訊息應該轉給哪個團隊處理?",
    "criteria": {
      "billing": "扣款、退款、發票、訂閱費用相關問題",
      "technical": "功能壞掉、登入失敗、錯誤訊息等技術問題",
      "account": "帳號設定、密碼、權限、資料變更",
      "other": "以上都不符合"
    }
  },
得到的結果置信度為 100%,選擇為 billing
這是問題2:
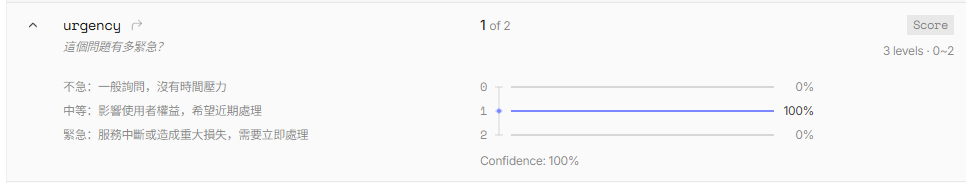
"urgency": {
    "type": "score",
    "instructions": "這個問題有多緊急?",
    "criteria": [
      "不急:一般詢問,沒有時間壓力",
      "中等:影響使用者權益,希望近期處理",
      "緊急:服務中斷或造成重大損失,需要立即處理"
    ]
  },
得到的結果為中等緊急度
第三題是否
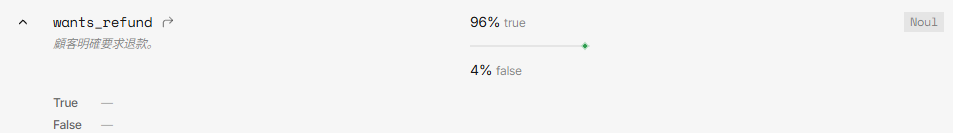
"wants_refund": {
    "type": "noul",
    "instructions": "顧客明確要求退款。"
  }
置信度 96%
測試完之後我們來深度了解 Jev,關於 Jev 其核心理念在於 RLCD,傳統的 RLHF(人類回饋強化學習) 雖然讓大模型說話很客氣、很像人類,但往往會導致模型「不懂裝懂」(過度自信地胡言亂語)。RLCD 的核心目標是訓練模型的「認知誠實(Epistemically Honest)」。當模型給出一個決策並標註「80% 信心度」時,在統計上,這類決策確實會有大約 80% 的正確率。
訓練特點:
- 放棄文字生成: 模型的輸出不再是字串(String),而是直接輸出結構化數據(JSON / Schema)以及對應的機率。
- 獎勵機制改變: 傳統 RLHF 的獎勵(Reward)來自於「人類喜不喜歡這個回答」。而 RLCD 的獎勵則完全基於「模型宣稱的機率是否與真實結果(Outcomes)一致」。 [1]
以 TypeSafe AI 的 Jev 模型為例,透過 RLCD 訓練的小模型(如 1B 大小),在執行對齊失效檢測、安全過濾或自動化路由等決策任務時,速度能提升數十至兩百倍,成本甚至暴降至傳統大模型裁判的六十三分之一,大幅擴展了 AI 在軟體工程底層自動化的可行性。
本質上,RLHF 優化的目標是「人類的偏好(Preference)」,而不是「客觀世界的真實機率(Empirical Truth)」。這導致模型為了迎合人類,在數學上走向了極端的「過度自信(Overconfidence)」。
具體可以從以下三個維度來剖析人類選擇如何破壞校準度:
-
口吻溢價(Sycophancy & Tone Bias):
人類在標註數據時,天生更喜歡聽起來「自信、博學、禮貌且井井有條」的回答。如果模型說:「這題我有 55% 的把握是 A」,對比另一個模型斬截地說:「毫無疑問,答案絕對是 A」,人類審查員往往會給後者打高分。這導致 RLHF 的獎勵模型(Reward Model)會瘋狂懲罰「表達不確定性」的模型,逼著大模型學會「不懂裝懂」。 -
環境與錨定效應(Context & Expectation):
人類的偏好高度受到當下所處環境與預期的干擾。例如,同樣一個帶有微小安全風險的回答,在「嚴格的安全測試環境」下會被判 0 分,但在「追求創意的聊天環境」下卻會被判高分。這種不穩定的 Reward 訊號,使得模型無法建立起一個客觀穩定的「機率尺標」。 -
數學上的坍縮(Bradley-Terry 模型的副作用):
RLHF 通常使用 Bradley-Terry 模型來將人類的兩兩偏好(A > B)轉化為標量分數。在優化過程中,為了讓 A 顯著優於 B,損失函數會逼迫 A 的 Reward 值無限拉高,B 的無限拉低。反映到模型的輸出機率上,就是將機率推向極端(接近 1 或接近 0),直接抹殺了中間地帶的機率精確度(例如 60% 或 70% 的微細差別)。