大模型安全探討
成員推斷攻擊(Membership Inference Attack)
目標: 判斷某筆資料是否曾經出現在模型的訓練集中。
攻擊原理&手段
模型對於訓練過的資料會表現出「過度自信」——因為見過這筆資料,所以預測時損失更低、信心度更高。
攻擊者輸入一筆資料 x
        ↓
查詢模型輸出(機率分佈、損失值、logits)
        ↓
觀察信心度是否異常高?損失是否異常低?
        ↓
推斷:x 是否在訓練集中?
urscos Tech.
目標: 判斷某筆資料是否曾經出現在模型的訓練集中。
模型對於訓練過的資料會表現出「過度自信」——因為見過這筆資料,所以預測時損失更低、信心度更高。
攻擊者輸入一筆資料 x
↓
查詢模型輸出(機率分佈、損失值、logits)
↓
觀察信心度是否異常高?損失是否異常低?
↓
推斷:x 是否在訓練集中?
這篇參考了 llmwiki 的做法,自己實作了一套 LLM + Obsidian 的個人 Wiki 系統,記錄一下整體架構與使用心得。
先定好資料夾分工,讓 AI 知道哪些是原始資料、哪些是它負責維護的知識庫:
my-llm-wiki/
├── raw/ # 原始數據(筆記、文章、資料來源)
├── wiki/ # AI 維護的知識庫文本
├── outputs/ # AI 生成的成品
└── CLAUDE.md # 系統規則文件
三個資料夾職責清楚分開,避免 AI 處理時混淆來源與產出。
前往官網下載 windows 版本
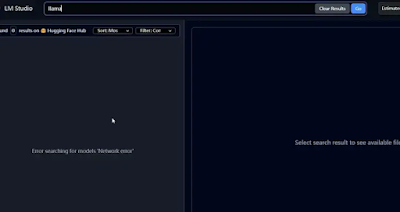
安裝後執行, 切換到 Search, 搜索後出現 network error
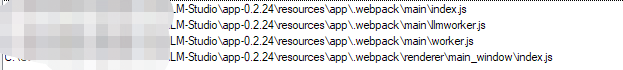
切換到安裝目錄下, 搜索 HuggingFace.co 替換成 hf-mirror.com
重啟 Lm Studio 搜索 TAIDE-LX-7B-Chat 出現結果了
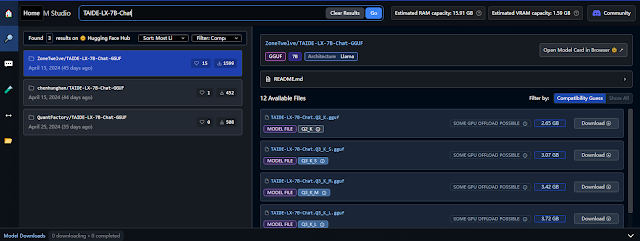
點下載
TAIDE-LX-78-Chat.Q2_K.gguf
另外, 我把下載 model 修改掉了, 具體切換到 My Models 分頁, 點 Change 修改目錄
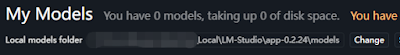
可以看到已經在下載了