CodeGraph 安裝與使用教學:整合 Claude Code、Cursor、Codex 的程式碼圖譜工具
在大型程式項目中通常會透過不同手段來優化 llm token 的使用效益,本篇文章將介紹如何使用 codegraph
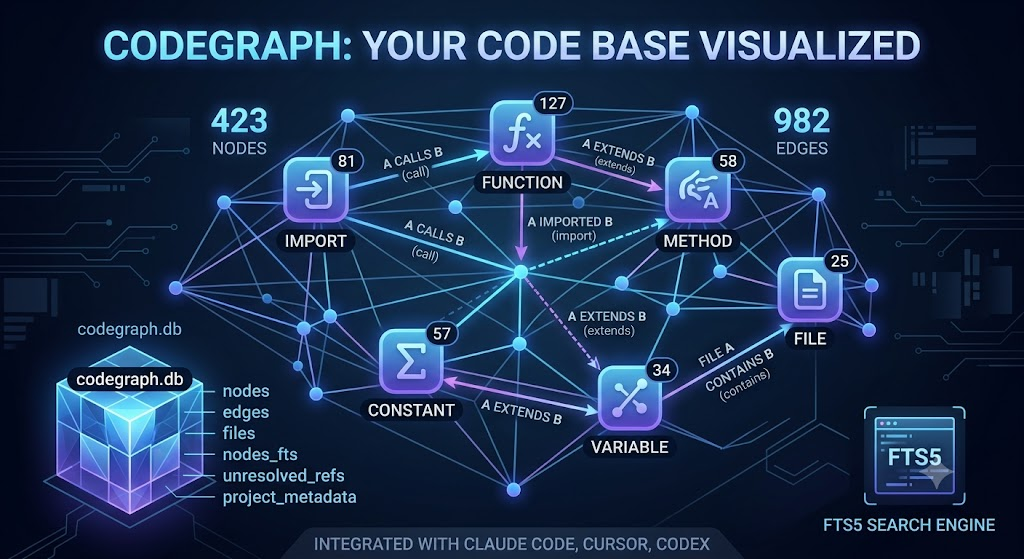
安裝 CLI
npm install -g @colbymchenry/codegraph
進入到項目中,安裝 codegraph,它會自動偵測並設定 Claude Code、Cursor、Codex
$ codegraph install
urscos Tech.
在大型程式項目中通常會透過不同手段來優化 llm token 的使用效益,本篇文章將介紹如何使用 codegraph
安裝 CLI
npm install -g @colbymchenry/codegraph
進入到項目中,安裝 codegraph,它會自動偵測並設定 Claude Code、Cursor、Codex
$ codegraph install
傳統的 IP 封鎖和 Rate Limit 正在失效。當對手能無限旋轉 IP、偽裝 Header, 你真正的防線藏在一個沒人注意的地方——U+2019,那個「右彎引號」。
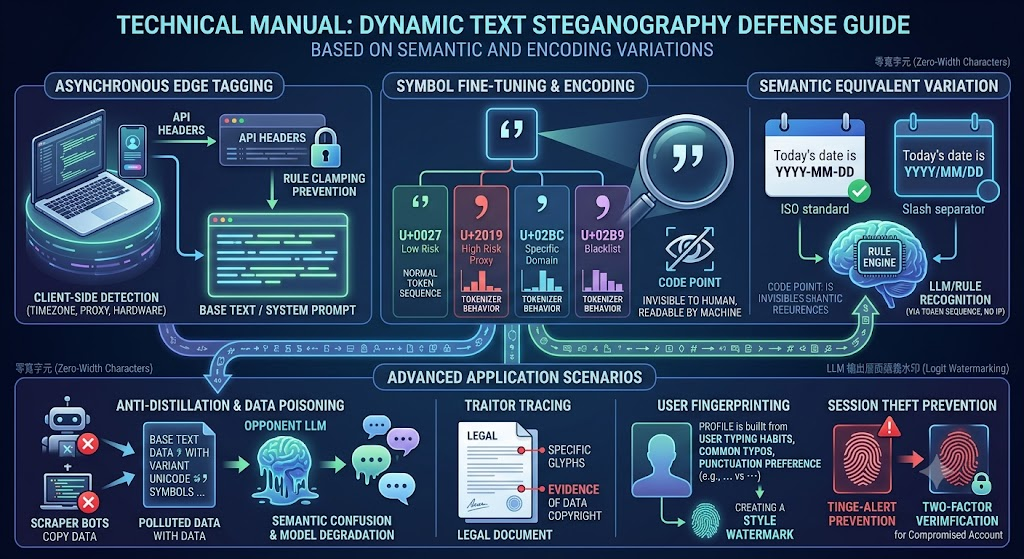
假設你花了幾年訓練一個垂直領域的 LLM,或者你的 API 輸出本身就是有價值的資產。 現在有人開始大量抓取你的輸出,用來微調(fine-tune)他們自己的模型。 傳統反爬蟲?封 IP——對方換 Proxy;加 Rate Limit——對方放慢速度; 要求登入——對方批量買帳號。
為什麼我不再讓我的 AI 助理每天早上重新學習整個程式碼庫,而是為它建立了一個能夠自我管理的記憶庫。
在游戲開發項目中整合 AI 助理最困難的部分不是模型本身,而是上下文。每次啟動,助手都要從零開始:重新閱讀程式碼庫,重新推導出某個功能的工作原理,最終得到的答案往往與昨天略有不同。與此同時,實際的知識分散在三個彼此矛盾的地方——每日提交記錄、代碼審查筆記和問題描述——而不懂 C# 的遊戲設計師仍然需要知道“這個功能涉及哪些方面,以及這個需求是否可行?”
Why I stopped letting my AI assistant re-learn the whole codebase every morning — and built it a memory that curates itself.
本章節要將情緒「分類」升級到「結構化輸出」
原本Stage 1 只回一個詞(喜悅)。Stage 2 要回一個 JSON 物件:
{
  "instruction": "分析以下文本的情緒,輸出 JSON:emotion(類別)、intensity(1-5)、trigger(觸發詞)、reasoning(分析過程)",
  "input": "他竟然在背後說我壞話,我真的快氣炸了",
  "output": {
    "emotion": "憤怒",
    "intensity": 4,
    "trigger": "背後說壞話",
    "reasoning": "「竟然」表示出乎意料的憤慨,「快氣炸了」是強烈憤怒的慣用表達"
  }
}
在這過程中要加入 COT,爲什麽呢?