分類 AI 下的文章

論文:Stealing Reasoning Traces from Proprietary LLM APIs

整體評價:這是一篇技術邏輯合理、實驗證據也相當有說服力的 LLM 安全研究。

不過,這篇論文真正揭露的並不是「LLM Provider 使用的加密演算法被破解」,而是 Reasoning State 的可攜性(Portability)與 Security Context Binding 不足所造成的安全問題。

攻擊者並沒有破解 AES、偽造 MAC 或取得 Encryption Key,而是利用 Provider 自己的 Backend Infrastructure 解密 Reasoning,再誘導另一個較容易被操控的模型將其轉錄成明文。

從這個角度來看,它更接近一種 Replay + Capability Boundary Failure + Model-assisted Exfiltration。
- 閱讀剩餘部分 -

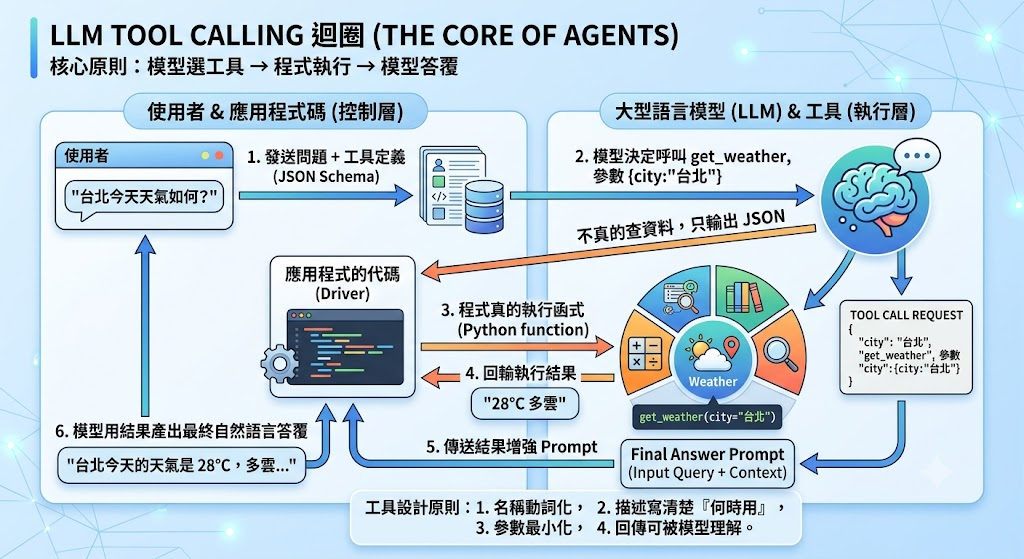
如何讓模型能呼叫外部工具,並親手實作「模型選工具 → 執行 → 回輸 → 答覆」的完整迴圈 核心原則
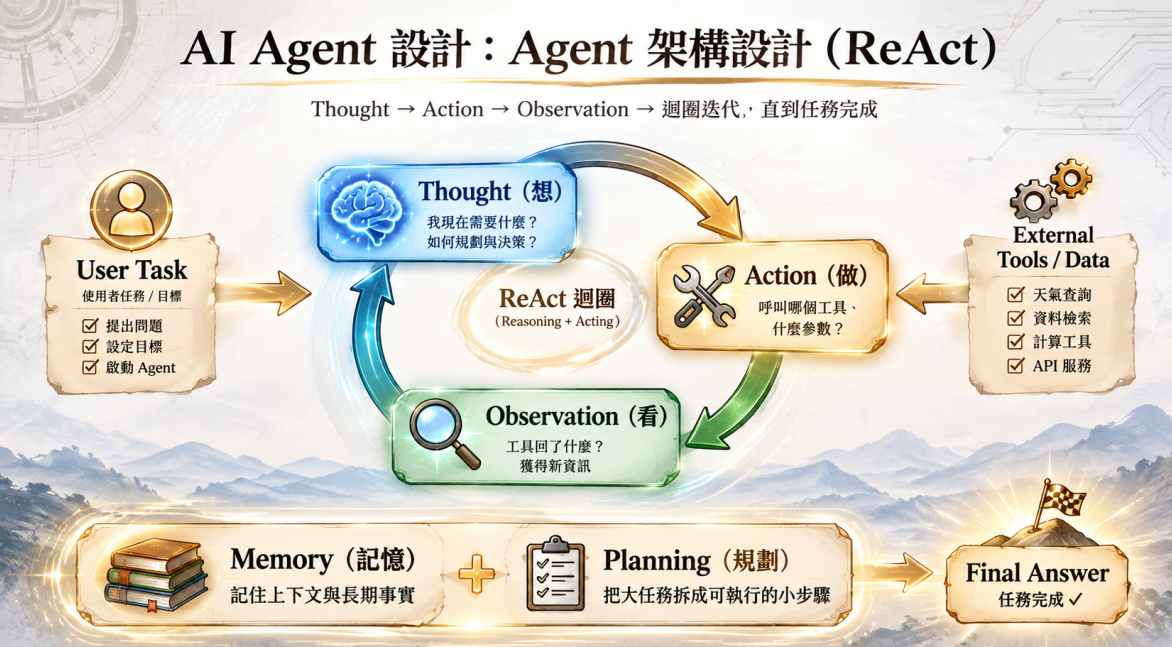
Tool Calling 是 Agent 的底層——Agent 不過是「會自己決定何時呼叫哪個工具的迴圈」

模型本身只會產生文字,不會真的算數、查資料、打 API。Tool Calling 的機制是:

07187-i14olny57p.png

1. 把工具的 JSON Schema 連同問題一起送給模型
2. 模型回答「我要呼叫 calculator,參數 {expression:'...'}」
3. 而程式(不是模型)真的去執行該函式
4. 再把執行結果回輸給模型
5. 模型用結果產出最終自然語言答覆

- 閱讀剩餘部分 -

延續上一篇的話題,關於 λ 的修正計算,如何更準確的預估或是計算出 λ 呢?

理論上 λ 應由「外部基準」決定,以下是三條可行的校準路徑:

PATH 1:對照官方建照數據

最直接的方法——以政府公布的「年度核發建照數」作為 ground truth,反推 λ:

λ* = log(N_t/N_0 / G_real) / log(C_t/C_0)

其中 G_real 為官方建照累計增長率。台中建管處(CPA)有公開資料,可據此反算出城市特定的 λ 值。

PATH 2:跨城市穩定性檢驗

若同一個 λ 值應用於台北、高雄、台中均能與官方數據對齊,則可視其為 OSM 系統性偏差的穩健估計,與個別城市無關。

- 閱讀剩餘部分 -