YOLOv8 麻將牌辨識實戰:imgsz 960 微調、萬子誤判分析與過擬合診斷
訓練進度
執行訓練,這次改用 imgsz 960,之前使用預設 640,訓練出來結果一直沒法超過 76%
python scripts/finetune.py --data dataset/ --model mahjong_yolov8n.pt --epochs 100 --imgsz 960 --batch 12 --output runs/finetune960
開始進行訓練
WARNING Ultralytics settings updated to the latest schema. Existing values were preserved where possible.
View Ultralytics Settings with 'yolo settings' or at 'C:\Users\joker\AppData\Roaming\Ultralytics\settings.json'
Update Settings with 'yolo settings key=value', i.e. 'yolo settings runs_dir=path/to/dir'. For help see https://docs.ultralytics.com/quickstart#ultralytics-settings.
數據集統計:
  訓練: 30 張圖片, 30 個標注
  驗證: 8 張圖片, 8 個標注
data.yaml path → J:/git/szmjcv/dataset

載入模型: mahjong_yolov8n.pt

開始訓練 (epochs=100, batch=12, imgsz=960)
輸出目錄: J:\git\szmjcv\runs\finetune960
Logging results to J:\git\szmjcv\runs\finetune960\train
Starting training for 100 epochs...

      Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
      1/100      4.02G      1.022      1.776     0.9603        615        960: 100% ━━━━━━━━━━━━ 3/3 1.6it/s 1.8s
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95): 100% ━━━━━━━━━━━━ 1/1 3.1it/s 0.3s
                   all          8        549      0.694      0.729      0.754      0.626

      Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
      2/100      4.19G     0.8996       1.63      0.896        631        960: 100% ━━━━━━━━━━━━ 3/3 4.6it/s 0.7s
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95): 100% ━━━━━━━━━━━━ 1/1 5.3it/s 0.2s
                   all          8        549      0.705      0.713       0.75      0.624

      Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
      3/100      5.44G     0.8701      1.548     0.8563       1108        960: 100% ━━━━━━━━━━━━ 3/3 4.1it/s 0.7s
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95): 100% ━━━━━━━━━━━━ 1/1 4.8it/s 0.2s
                   all          8        549      0.787      0.649      0.747      0.618
    Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
    100/100      3.82G     0.5324     0.6743     0.8141        402        960: 100% ━━━━━━━━━━━━ 3/3 5.6it/s 0.5s
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95): 100% ━━━━━━━━━━━━ 1/1 3.7it/s 0.3s
                   all          8        549      0.911      0.917      0.953       0.85

100 epochs completed in 0.040 hours.
Optimizer stripped from J:\git\szmjcv\runs\finetune960\train\weights\last.pt, 6.3MB
Optimizer stripped from J:\git\szmjcv\runs\finetune960\train\weights\best.pt, 6.3MB

Validating J:\git\szmjcv\runs\finetune960\train\weights\best.pt...
Ultralytics 8.4.132  Python-3.12.12 torch-2.6.0+cu124 CUDA:0 (NVIDIA GeForce RTX 4060 Laptop GPU, 8188MiB)
Model summary (fused): 73 layers, 3,013,838 parameters, 0 gradients, 8.1 GFLOPs
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95): 100% ━━━━━━━━━━━━ 1/1 3.7it/s 0.3s
                   all          8        549      0.929      0.939      0.964      0.866
                   1ti          8         23          1      0.996      0.995      0.911
                   1to          8         23      0.984          1      0.995      0.896
                    1w          8         19      0.888          1      0.993      0.893
                   2ti          7         15      0.963          1      0.995      0.832
                   2to          7         12      0.966          1      0.995      0.889
                    2w          7         15       0.74        0.8       0.87       0.79
                   3ti          8         12      0.966          1      0.995       0.88
                   3to          7         15      0.951          1      0.995      0.888
                    3w          7         14       0.92      0.822      0.927      0.866
                   4ti          7         13      0.955          1      0.995      0.892
                   4to          8         18      0.971          1      0.995      0.902
                    4w          8         13          1      0.928      0.995      0.864
                   5ti          7         20      0.973          1      0.995      0.936
                   5to          8         18      0.972          1      0.995      0.885
                    5w          7         14      0.731      0.778      0.816      0.739
                   6ti          8         14      0.958          1      0.995      0.949
                   6to          7         14      0.969          1      0.995      0.909
                    6w          7         16      0.881      0.625      0.881      0.803
                   7ti          8         16      0.966          1      0.995      0.905
                   7to          8         18      0.981          1      0.995      0.949
                    7w          8         18      0.812      0.482      0.761      0.623
                   8ti          8         14      0.965          1      0.995      0.932
                   8to          8         19      0.954          1      0.995      0.934
                    8w          7         16          1      0.855      0.995      0.817
                   9ti          8         18      0.976          1      0.995      0.889
                   9to          7         15      0.961          1      0.995      0.921
                    9w          8         17      0.865      0.753      0.855      0.706
                   bai          7         13      0.965          1      0.995      0.908
                   bei          8         20      0.949          1      0.995      0.857
                  dong          8         18        0.9      0.944       0.93      0.829
                    fa          7         16      0.896          1      0.995      0.929
                   nan          7         13      0.704          1      0.857      0.762
                    xi          8         15      0.944      0.933      0.991       0.84
                 zhong          8         15      0.971          1      0.995      0.903
Speed: 0.3ms preprocess, 2.1ms inference, 0.0ms loss, 3.5ms postprocess per image
Results saved to J:\git\szmjcv\runs\finetune960\train

訓練完成!最佳模型: J:\git\szmjcv\runs\finetune960\train\weights\best.pt
訓練摘要: P=0.9294 R=0.9387 mAP50=0.9636 mAP50-95=0.8655
  歷史記錄: runs\train_history.csv
  本次歸檔: runs\history\2026-09-13_231608
本次訓練結果
| 指標 | 值 |
|---|---|
| P / R | 0.929 / 0.939 |
| mAP50 | 0.9636 |
| mAP50-95 | 0.8655 |
但發現這次訓練結果問題在於萬子(其餘花色幾乎都 R=1.0、mAP50=0.995):
7w R=0.482、mAP50=0.761、mAP50-95=0.623 ← 最差
5w P/R=0.731/0.778、mAP50=0.816
6w R=0.625;2w R=0.800;3w R=0.822
兩個情況
- 訓練集只有 30 張、驗證集 8 張,val 上 549 個框但每類僅 12–23 個實例。這種規模下 mAP 波動大,萬子的低 recall 很可能是樣本不并不是模型容量問題,需要補萬子,尤其 5w/6w/7w 的標註圖,這會比增加 epoch 有用得多。
- 過擬合問題,mAP50 在 epoch 78–80 見頂(0.964),關 mosaic 後(epoch 91+)反而降到 0.953。100 epochs 對這份資料已經偏多
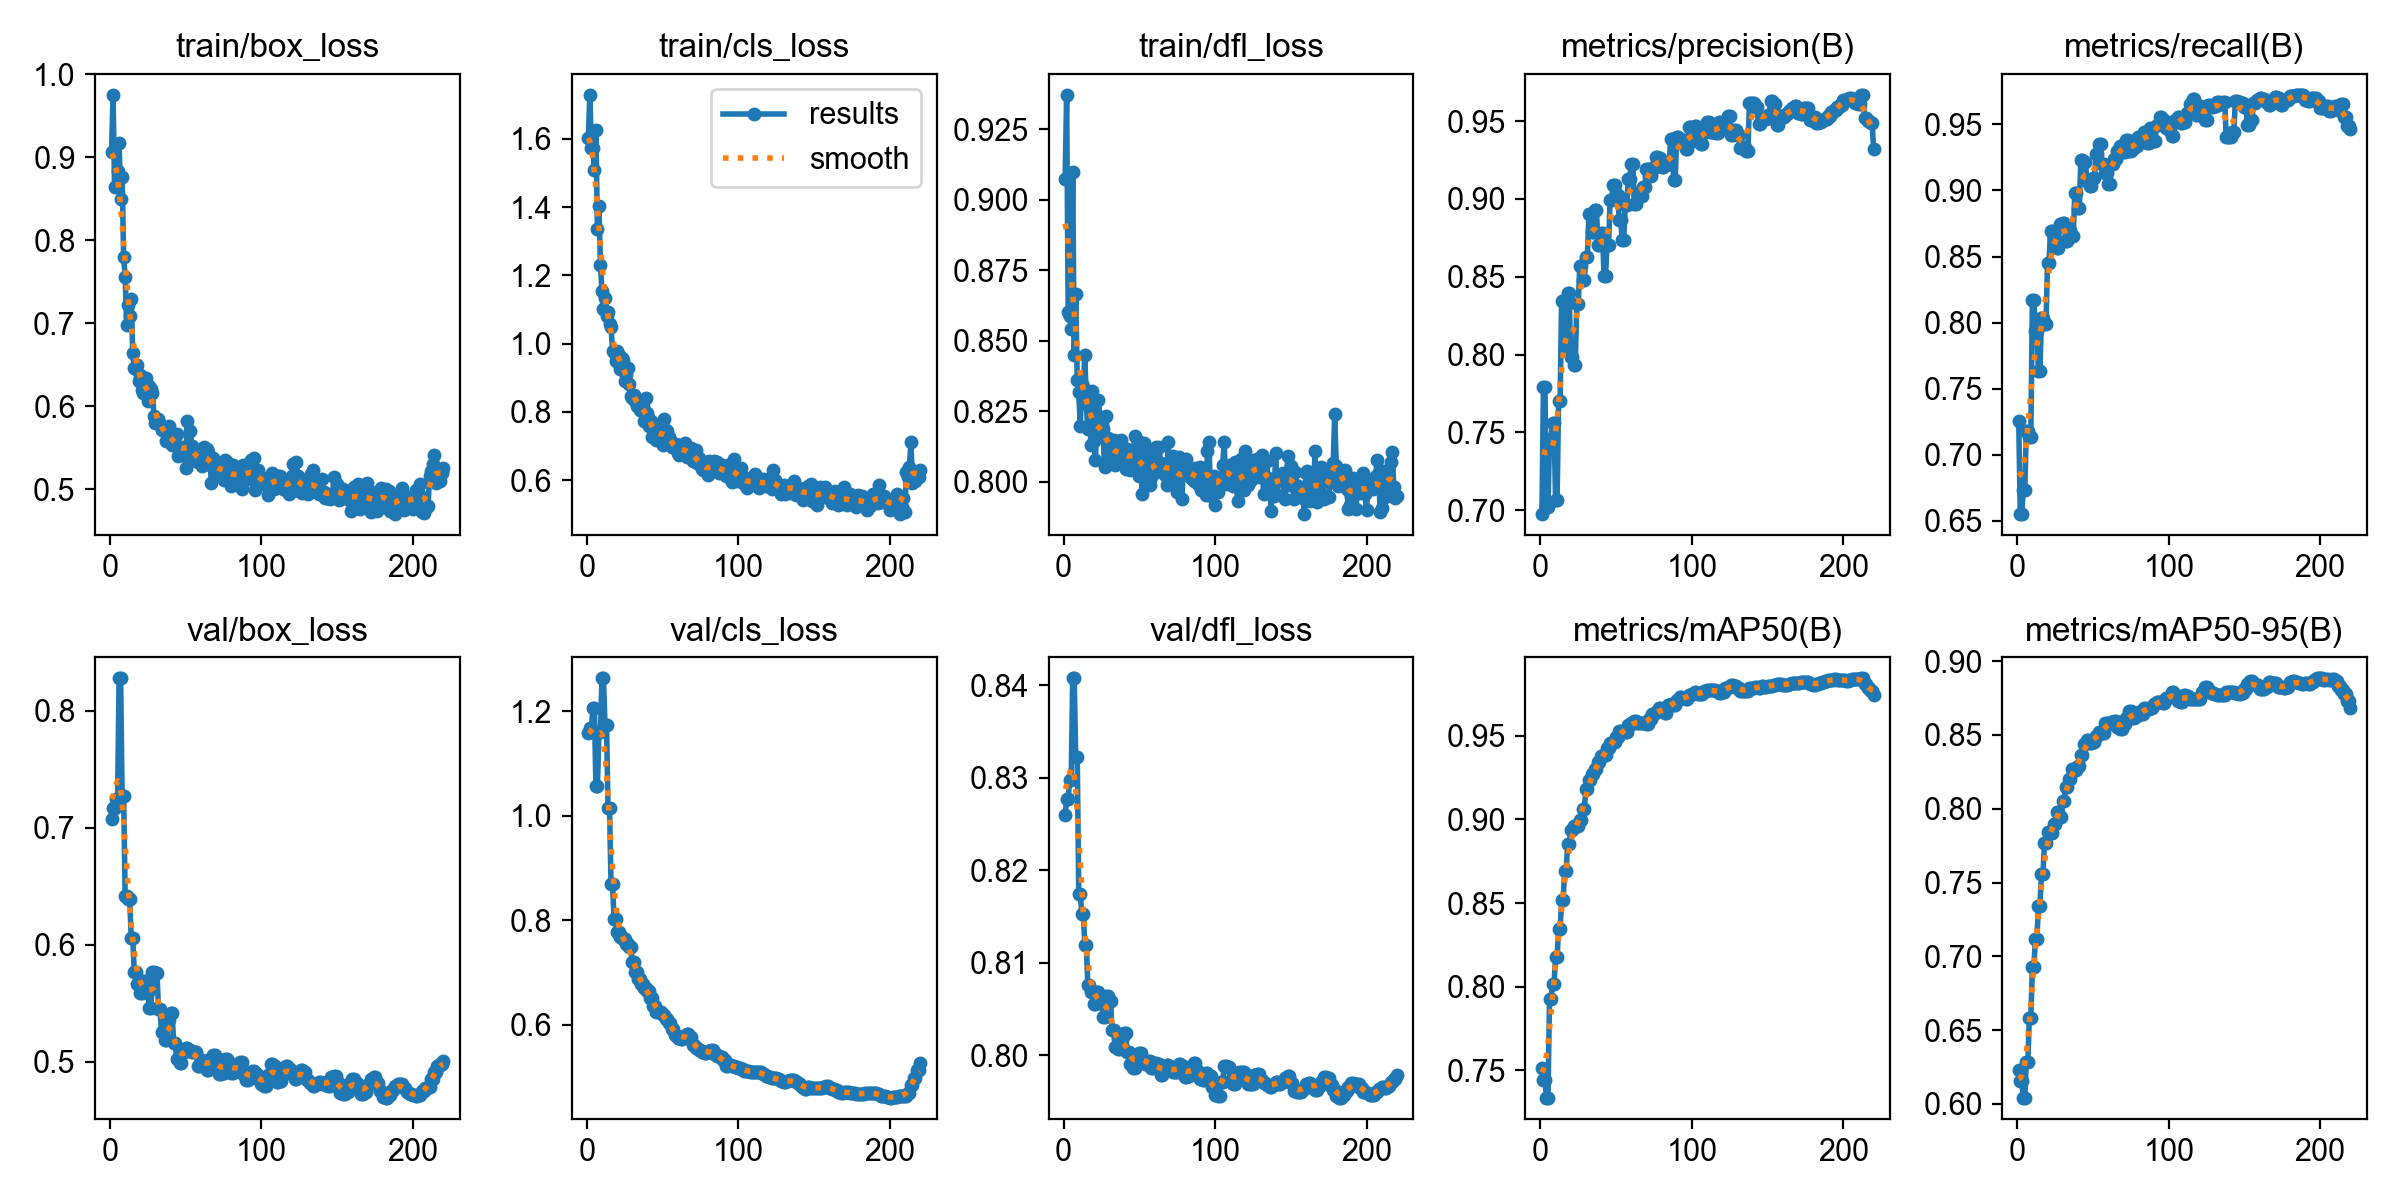
下面説明下各個指標意義
| 欄位 | 意思 |
|---|---|
| Epoch | 目前第幾輪 / 總共幾輪(1/220)。一個 epoch = 把 30 張訓練圖全部看過一遍 |
| GPU_mem | 這一輪佔用的 GPU 顯存(4.64G)。你的 RTX 3060 有 12G,還很寬裕,batch 其實可以往上加 |
| box_loss | 定位損失 — 預測框的位置/大小跟真實框差多少。越小代表框畫得越準 |
| cls_loss | 分類損失 — 框裡那張牌「是哪一種牌」判斷錯多少。42 類麻將牌,這個是關鍵指標 |
| dfl_loss | Distribution Focal Loss — 框邊界的精細回歸損失,幫助框的邊緣更貼合。box_loss 的輔助項 |
| Instances | 這個 batch 裡總共有幾個標注物件(714 個牌框)。會隨 batch 內容浮動 |
| Size | 訓練輸入解析度(1280),對應你 --imgsz 1280 |
三個 loss 都是越低越好,趨勢比絕對值重要 —— 看它是否穩定下降。
驗證指標行
       Class     Images  Instances    Box(P        R      mAP50   mAP50-95)
         all          8        549      0.618    0.464      0.51      0.385
每個 epoch 訓練完,拿 8 張驗證圖跑一次評估:
| 欄位 | 意思 |
|---|---|
| Class | 類別(all = 所有類平均;verbose=True 時後面還會列各別牌種) |
| Images | 驗證圖數量(8 張) |
| Instances | 驗證集總標注框數(549 個) |
| Box(P) | Precision 精確率 — 模型說「這是牌」的框裡,有多少真的是牌(不亂報) |
| R | Recall 召回率 — 實際存在的牌,模型抓到了多少(不漏抓) |
| mAP50 | IoU 門檻 0.5 下的平均精度。最常看的總體分數 |
| mAP50-95 | IoU 從 0.5 到 0.95 逐級平均,最嚴格的綜合指標,論文/正式評比都看這個 |
这四個 都是越高越好,範圍 0~1。
實務提醒
-
資料量太小是個隱憂,30 張訓練 / 8 張驗證,對 42 類牌來說非常少。很容易 loss 降得漂亮但實際泛化差(過擬合),這也是為什麼 mAP 前幾個 epoch 就衝到 0.5 又停住。
-
并且看指標別只看某個 epoch ,訓練結束後看上面訓練的的曲線,重點是 mAP50-95 是否還在爬;若很早就平掉,加資料比加 epoch 有用。
-
前幾輪 mAP 反覆正常,epoch 2/3 完全一樣(0.487)是因為驗證集只有 8 張、549 框,粒度粗;別因為單輪波動就緊張。
-
然後發現顯存還有使用空間,過程只使用到 4
6G 而已,12,訓練會更穩更快。--batch 6可以試著加到 10
如果模型是 960 imgsize,則 benchmark 也必須采用 960,不然準確率會下降,因此,大部分模型在訓練時用的圖像大小在偵測時就必須將圖像采樣到對應大小,避免因爲數據源大小不一致造成的準確率下降。
最後我們來跑一次benchmark,這個是同時跑兩組 model,一組是從之前訓練基礎來的(mahjong_yolov8n.pt),一組是我們剛剛訓練好的 960 模型
python scripts/benchmark.py --model mahjong_yolov8n.pt runs/finetune960/train/weights/best.pt
(py3.12) J:\git\szmjcv>python scripts/benchmark.py --model mahjong_yolov8n.pt runs/finetune960/train/weights/best.pt
  mahjong_yolov8n.pt: 依訓練設定使用 imgsz=640
  runs\finetune960\train\weights\best.pt: 依訓練設定使用 imgsz=960

gameshot_02(train,69 框)
   mahjong_yolov8n.pt                       52/69  =  75.4%   類別錯 13  漏檢  4  多餘  0
   runs\finetune960\train\weights\best.pt   68/69  =  98.6%   類別錯  1  漏檢  0  多餘  0

gameshot_03(train,85 框)
   mahjong_yolov8n.pt                       55/85  =  64.7%   類別錯 11  漏檢 19  多餘  7
   runs\finetune960\train\weights\best.pt   85/85  = 100.0%   類別錯  0  漏檢  0  多餘  0

gameshot_04(train,80 框)
   mahjong_yolov8n.pt                       49/80  =  61.3%   類別錯 21  漏檢 10  多餘  0
   runs\finetune960\train\weights\best.pt   78/80  =  97.5%   類別錯  1  漏檢  1  多餘  0

gameshot_05(train,64 框)
   mahjong_yolov8n.pt                       45/64  =  70.3%   類別錯 17  漏檢  2  多餘  1
   runs\finetune960\train\weights\best.pt   64/64  = 100.0%   類別錯  0  漏檢  0  多餘  0

gameshot_06(train,65 框)
   mahjong_yolov8n.pt                       50/65  =  76.9%   類別錯  8  漏檢  7  多餘  0
   runs\finetune960\train\weights\best.pt   64/65  =  98.5%   類別錯  1  漏檢  0  多餘  0

gameshot_07(train,87 框)
   mahjong_yolov8n.pt                       67/87  =  77.0%   類別錯 15  漏檢  5  多餘  0
   runs\finetune960\train\weights\best.pt   85/87  =  97.7%   類別錯  1  漏檢  1  多餘  0

gameshot_08(train,49 框)
   mahjong_yolov8n.pt                       36/49  =  73.5%   類別錯 10  漏檢  3  多餘  3
   runs\finetune960\train\weights\best.pt   47/49  =  95.9%   類別錯  1  漏檢  1  多餘  0

gameshot_09(train,75 框)
   mahjong_yolov8n.pt                       53/75  =  70.7%   類別錯  9  漏檢 13  多餘  0
   runs\finetune960\train\weights\best.pt   72/75  =  96.0%   類別錯  3  漏檢  0  多餘  0

gameshot_10(train,88 框)
   mahjong_yolov8n.pt                       54/88  =  61.4%   類別錯 19  漏檢 15  多餘  0
   runs\finetune960\train\weights\best.pt   87/88  =  98.9%   類別錯  1  漏檢  0  多餘  0

gameshot_11(train,98 框)
   mahjong_yolov8n.pt                       63/98  =  64.3%   類別錯 16  漏檢 19  多餘  0
   runs\finetune960\train\weights\best.pt   92/98  =  93.9%   類別錯  5  漏檢  1  多餘  0

gameshot_14(train,69 框)
   mahjong_yolov8n.pt                       45/69  =  65.2%   類別錯 14  漏檢 10  多餘  1
   runs\finetune960\train\weights\best.pt   67/69  =  97.1%   類別錯  1  漏檢  1  多餘  0

gameshot_15(train,69 框)
   mahjong_yolov8n.pt                       46/69  =  66.7%   類別錯 13  漏檢 10  多餘  1
   runs\finetune960\train\weights\best.pt   68/69  =  98.6%   類別錯  0  漏檢  1  多餘  0

gameshot_16(train,54 框)
   mahjong_yolov8n.pt                       39/54  =  72.2%   類別錯 12  漏檢  3  多餘  0
   runs\finetune960\train\weights\best.pt   52/54  =  96.3%   類別錯  1  漏檢  1  多餘  2

gameshot_17(train,53 框)
   mahjong_yolov8n.pt                       37/53  =  69.8%   類別錯 13  漏檢  3  多餘  1
   runs\finetune960\train\weights\best.pt   51/53  =  96.2%   類別錯  2  漏檢  0  多餘  2

gameshot_18(train,76 框)
   mahjong_yolov8n.pt                       49/76  =  64.5%   類別錯 13  漏檢 14  多餘  4
   runs\finetune960\train\weights\best.pt   72/76  =  94.7%   類別錯  4  漏檢  0  多餘  1

gameshot_19(train,61 框)
   mahjong_yolov8n.pt                       39/61  =  63.9%   類別錯  8  漏檢 14  多餘  0
   runs\finetune960\train\weights\best.pt   57/61  =  93.4%   類別錯  4  漏檢  0  多餘  1

gameshot_20(train,59 框)
   mahjong_yolov8n.pt                       45/59  =  76.3%   類別錯  6  漏檢  8  多餘  2
   runs\finetune960\train\weights\best.pt   56/59  =  94.9%   類別錯  3  漏檢  0  多餘  0

gameshot_21(train,63 框)
   mahjong_yolov8n.pt                       42/63  =  66.7%   類別錯  7  漏檢 14  多餘  1
   runs\finetune960\train\weights\best.pt   61/63  =  96.8%   類別錯  2  漏檢  0  多餘  0

gameshot_22(train,68 框)
   mahjong_yolov8n.pt                       46/68  =  67.6%   類別錯 11  漏檢 11  多餘  0
   runs\finetune960\train\weights\best.pt   64/68  =  94.1%   類別錯  4  漏檢  0  多餘  0

gameshot_23(train,63 框)
   mahjong_yolov8n.pt                       40/63  =  63.5%   類別錯 16  漏檢  7  多餘  1
   runs\finetune960\train\weights\best.pt   61/63  =  96.8%   類別錯  2  漏檢  0  多餘  0

gameshot_24(train,71 框)
   mahjong_yolov8n.pt                       45/71  =  63.4%   類別錯 13  漏檢 13  多餘  0
   runs\finetune960\train\weights\best.pt   67/71  =  94.4%   類別錯  3  漏檢  1  多餘  0

gameshot_25(train,64 框)
   mahjong_yolov8n.pt                       40/64  =  62.5%   類別錯 20  漏檢  4  多餘  3
   runs\finetune960\train\weights\best.pt   59/64  =  92.2%   類別錯  5  漏檢  0  多餘  0

gameshot_26(train,61 框)
   mahjong_yolov8n.pt                       42/61  =  68.9%   類別錯  8  漏檢 11  多餘  0
   runs\finetune960\train\weights\best.pt   60/61  =  98.4%   類別錯  1  漏檢  0  多餘  0

gameshot_27(train,61 框)
   mahjong_yolov8n.pt                       44/61  =  72.1%   類別錯 11  漏檢  6  多餘  2
   runs\finetune960\train\weights\best.pt   59/61  =  96.7%   類別錯  2  漏檢  0  多餘  0

gameshot_28(train,61 框)
   mahjong_yolov8n.pt                       40/61  =  65.6%   類別錯 13  漏檢  8  多餘  0
   runs\finetune960\train\weights\best.pt   59/61  =  96.7%   類別錯  2  漏檢  0  多餘  0

gameshot_29(train,68 框)
   mahjong_yolov8n.pt                       44/68  =  64.7%   類別錯 17  漏檢  7  多餘  1
   runs\finetune960\train\weights\best.pt   65/68  =  95.6%   類別錯  3  漏檢  0  多餘  0

gameshot_30(train,69 框)
   mahjong_yolov8n.pt                       51/69  =  73.9%   類別錯 14  漏檢  4  多餘  0
   runs\finetune960\train\weights\best.pt   67/69  =  97.1%   類別錯  2  漏檢  0  多餘  0

gameshot_31(train,85 框)
   mahjong_yolov8n.pt                       55/85  =  64.7%   類別錯 11  漏檢 19  多餘  7
   runs\finetune960\train\weights\best.pt   85/85  = 100.0%   類別錯  0  漏檢  0  多餘  0

gameshot_32(train,80 框)
   mahjong_yolov8n.pt                       49/80  =  61.3%   類別錯 21  漏檢 10  多餘  0
   runs\finetune960\train\weights\best.pt   78/80  =  97.5%   類別錯  1  漏檢  1  多餘  0

gameshot_33(train,64 框)
   mahjong_yolov8n.pt                       45/64  =  70.3%   類別錯 17  漏檢  2  多餘  1
   runs\finetune960\train\weights\best.pt   64/64  = 100.0%   類別錯  0  漏檢  0  多餘  0

gameshot_12(val,59 框)
   mahjong_yolov8n.pt                       39/59  =  66.1%   類別錯 14  漏檢  6  多餘  0
   runs\finetune960\train\weights\best.pt   55/59  =  93.2%   類別錯  4  漏檢  0  多餘  0

gameshot_13(val,66 框)
   mahjong_yolov8n.pt                       50/66  =  75.8%   類別錯 10  漏檢  6  多餘  3
   runs\finetune960\train\weights\best.pt   62/66  =  93.9%   類別錯  4  漏檢  0  多餘  0

gameshot_34(val,80 框)
   mahjong_yolov8n.pt                       52/80  =  65.0%   類別錯 19  漏檢  9  多餘  1
   runs\finetune960\train\weights\best.pt   71/80  =  88.8%   類別錯  8  漏檢  1  多餘  0

gameshot_35(val,65 框)
   mahjong_yolov8n.pt                       50/65  =  76.9%   類別錯  8  漏檢  7  多餘  0
   runs\finetune960\train\weights\best.pt   64/65  =  98.5%   類別錯  1  漏檢  0  多餘  0

gameshot_36(val,68 框)
   mahjong_yolov8n.pt                       47/68  =  69.1%   類別錯 10  漏檢 11  多餘  1
   runs\finetune960\train\weights\best.pt   65/68  =  95.6%   類別錯  3  漏檢  0  多餘  0

gameshot_37(val,87 框)
   mahjong_yolov8n.pt                       67/87  =  77.0%   類別錯 15  漏檢  5  多餘  0
   runs\finetune960\train\weights\best.pt   85/87  =  97.7%   類別錯  1  漏檢  1  多餘  0

gameshot_38(val,49 框)
   mahjong_yolov8n.pt                       36/49  =  73.5%   類別錯 10  漏檢  3  多餘  3
   runs\finetune960\train\weights\best.pt   47/49  =  95.9%   類別錯  1  漏檢  1  多餘  0

gameshot_39(val,75 框)
   mahjong_yolov8n.pt                       53/75  =  70.7%   類別錯  9  漏檢 13  多餘  0
   runs\finetune960\train\weights\best.pt   72/75  =  96.0%   類別錯  3  漏檢  0  多餘  0

=== 合計(train 30 張 / val 8 張)===
                                                    train 訓練過·含記憶             val 沒訓練過·真實能力
   mahjong_yolov8n.pt                          1407/2079 =  67.7%         394/549  =  71.8%
   runs\finetune960\train\weights\best.pt      2014/2079 =  96.9%         521/549  =  94.9%

=== mahjong_yolov8n.pt 的錯誤集中在哪 ===
  類別錯(共 492 次,前 15 組)
    北    → 東     28 次  ############################
    發    → 一索    27 次  ###########################
    七筒   → 六筒    25 次  #########################
    南    → 西     22 次  ######################
    東    → 南     21 次  #####################
    六萬   → 五萬    20 次  ####################
    二萬   → 三萬    18 次  ##################
    南    → 東     15 次  ###############
    三萬   → 五萬    14 次  ##############
    東    → 西     12 次  ############
    九萬   → 五萬    12 次  ############
    九萬   → 三萬    11 次  ###########
    西    → 南     11 次  ###########
    九萬   → 東     10 次  ##########
    二萬   → 五萬    10 次  ##########
  漏檢(共 335 次,前 8 類)
    六萬    31 次
    七萬    30 次
    一萬    29 次
    二萬    25 次
    五萬    23 次
    八萬    22 次
    三萬    21 次
    四萬    21 次

=== runs\finetune960\train\weights\best.pt 的錯誤集中在哪 ===
  類別錯(共 81 次,前 15 組)
    六萬   → 五萬    14 次  ##############
    七萬   → 六萬     7 次  #######
    二萬   → 三萬     7 次  #######
    南    → 東      5 次  #####
    三萬   → 二萬     4 次  ####
    東    → 南      4 次  ####
    七萬   → 五萬     4 次  ####
    七萬   → 九萬     4 次  ####
    五萬   → 九萬     3 次  ###
    六萬   → 九萬     3 次  ###
    五萬   → 四萬     3 次  ###
    八萬   → 五萬     2 次  ##
    西    → 南      2 次  ##
    二萬   → 一萬     2 次  ##
    發    → 一索     2 次  ##
  漏檢(共 12 次,前 8 類)
    七萬     4 次
    六萬     2 次
    五萬     2 次
    三萬     2 次
    二索     1 次
    花      1 次
可以看到錯誤類集中在萬子