Dify 多模型除錯實測:從 Docker 日誌拆解 plugin_daemon、Token 成本與 Claude vs Ollama 延遲
打印docker log
docker compose logs -f --tail 20 api plugin_daemon
「多模型除錯」的請求:同一個問題同時送給 Claude 和 Ollama。這段 log 可以分成四部分來看。
1. 請求路徑:對照 trace --kind chat
瀏覽器 → nginx → api ──POST /plugin/{tenant}/dispatch/llm/invoke──▶ plugin_daemon:5002
└─ 插件 langgenius/anthropic:0.3.39
└─ HTTPS → Anthropic API(串流)
- client_ip=172.22.0.10 是 api 容器在 Docker 內網的 IP,代表呼叫 plugin_daemon 的是 api,不是瀏覽器。
- tenant_id=7067028a-… 是你的工作區 ID,插件呼叫都會帶上它,做多租戶隔離。
- api 本身不會直接打 Anthropic。所有模型呼叫都由 plugin_daemon 裡的插件發出,所以 Ollama 的位址才不能填 localhost。
2. Anthropic 串流事件:一次回應的完整生命週期
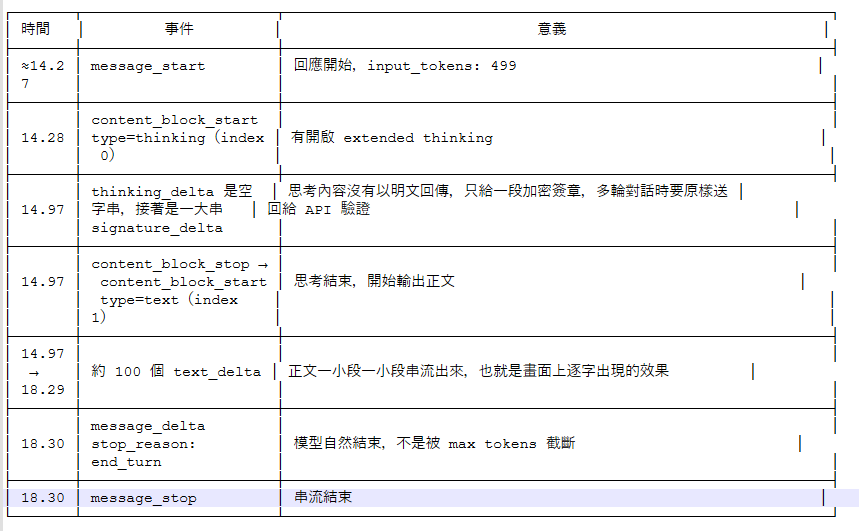
結算時 usage 的重點:
- output_tokens: 399,其中 thinking_tokens: 61。思考的 token 也算在輸出費用裡,雖然你在畫面上看不到內容。
- cache_read_input_tokens: 0、cache_creation_input_tokens: 0:沒有用到 prompt caching,每次都是全價計算輸入。
- input_tokens: 499:你只問了一句,卻有 499 個輸入 token,因為裡面包含系統提示詞和前面那輪天氣問答的對話歷史。Chatbot 每一輪都會把歷史一起送出,所以對話越長越貴。這在模組 02 和 05 的記憶設定會再講。
3. 延遲拆解:兩個模型的比較
plugin_daemon 的 latency_ms 是從收到請求到串流結束的總時間:
┌──────────────┬──────────────────────────┬────────────────────┐
│ │ Claude(anthropic 插件) │ Ollama(qwen3:8b) │
├──────────────┼──────────────────────────┼────────────────────┤
│ 結束時間 │ 06:03:18.30 │ 06:03:19.26 │
├──────────────┼──────────────────────────┼────────────────────┤
│ latency_ms │ 6790 │ 7747 │
├──────────────┼──────────────────────────┼────────────────────┤
│ 推算開始時間 │ ≈ 11.51 │ ≈ 11.51 │
└──────────────┴──────────────────────────┴────────────────────┘
兩個請求在同一時間發出,這是多模型除錯並行呼叫的結果。Claude 這一筆可以再拆開:
- 約 2.8 秒:從發出請求到收到 message_start,包含網路往返和排隊。
- 約 0.7 秒:思考階段。
- 約 3.3 秒:輸出正文,大約 390 個 token,換算約 120 token/s。
Ollama 這邊沒有逐段的 log,因為 ollama 插件不會印出每個串流片段,只看得到總時間。